Modelo McCulloch-Pitts
Para que seja possível iniciar uma discussão acerca de redes neurais artificiais, é necessário voltar a atenção para o primeiro modelo de neurônio biológico proposto por McCulloch e Pitts em 1943. Este é o modelo mais clássico de neurônio em RNA (redes neurais artificiais), proposto em um trabalho intitulado “Um cálculo lógico das ideias intrínsecas da atividade neural” Zuben & Attux (2007).
Em um neurônio biológico, as sinapses possuem canais que permitem a entrada e saída de íons de modo que torna o neurônio capaz de receber sinais de entrada através da mesma. Dependendo da intensidade resultante destes sinais de entrada, isto é, se a intensidade resultante for superior a um determinado limiar, o neurônio libera neurotransmissores na sinapse, o que por sua vez corresponde à emissão de um sinal de saída.
McCulloch e Pitts então empreenderam a primeira tentativa de entender a atividade neural a partir de unidades elementares da computação, construindo um modelo baseado em simplificações do que se sabia na época sobre o neurônio biológico. Seu modelo é baseado principalmente nas seguintes premissas Zuben & Attux (2007),Rodrigues (2014):
O neurônio tem apenas dois estados: ativo (1) ou inativo (0);
Uma certa quantidade fixa de sinapses deve ser excitada de forma a excitar o neurônio;
A atividade de uma sinapse inibitória bloqueia completamente a atividade do neurônio.
Matematicamente então, o neurônio de McCulloch Pitts, a cada iteração:
Soma as entradas com peso unitário ;
Se esse valor ultrapassar um limiar , e a entrada inibitória não estiver ativa (0), o neurônio é ativado (1);
Se não, o neurônio permanece inativo (0).
Isto é:
Evidentemente, esse modelo apresenta algumas limitações, dentre elas pode-se destacar que o mesmo não é capaz de aprender a partir dos dados disponíveis nem diferenciar a importância das entradas e, por fim, a entrada inibitória ainda pode ser uma limitação inconveniente.
Modelo de Rosenblatt
Nos anos de 1950 e 1960, Frank Rosenblatt, inspirado pelo trabalho de Warren McCulloch e Waltper Pitts, desenvolve seu próprio modelo, conhecido também como perceptron Nielsen (2015). Rossenblatt propôs modificações simples para o cálculo da saída, dentre as quais pode-se destacar a introdução de pesos diferentes para cada entrada e a remoção da entrada inibitória.
Utilizando os pesos, foi capaz de expressar as diferentes importâncias que cada entrada poderia possuir. Então sendo o peso correspondente à entrada e mantendo a notação do limiar , a saída do neurônio é dada por:
Onde foi pequena alteração da notação, o limiar foi passado para outro lado da igualdade, onde recebe o nome de viés () . Isto é:
o somatório do produto entre pesos e entradas pode ser escrito como um produto interno, utilizando a notação da Mecânica Quântica:
Onde:
Pode-se perceber que o viés é equivalente a uma entrada com um peso . Um exemplo prático da usabilidade de perceptrons é a possibilidade de construção da porta lógica NAND. Considerando um perceptron com um viés de e duas entradas com pesos iguais , e passando a denotar o somatório como função ativação tem-se:
A partir da função ativação é possível construir a seguinte tabela de entradas e saídas:
| 0 | 0 | 3 | 1 |
| 1 | 0 | 1 | 1 |
| 0 | 1 | 1 | 1 |
| 1 | 1 | -1 | 0 |
Esta tabela é idêntica a tabela verdade da porta NAND. A NAND é uma porta universal para a computação clássica. Deste modo, o perceptron também é universal para a computação clássica, e através de uma rede de perceptrons é possível computar qualquer função lógica Nielsen (2015).
Porém, a maior novidade que surge em comparação ao modelo anterior, é que uma vez que a entrada inibitória pode ser simulada por entradas simples Rojas (1996), a remoção dela junto com as outras modificações propostas por Rosenblatt tornou seu modelo mais flexível, e concedeu a capacidade ao perceptron de ter seus pesos e viés atualizados através de um algoritmo de aprendizado. Isto é, sem uma intervenção direta pelo programador. O algoritmo de aprendizagem nos permite resolver problemas que são extremamente difíceis de se propor um modelo diretamente, um exemplo que podemos citar são problemas de classificação de imagens.
Regra de aprendizado
Rosenblatt provou que a regra de aprendizado proposta em seu trabalho sempre converge para os pesos corretos para resolver o problema em questão, se estes pesos existirem. A regra de aprendizado também é conhecida como algoritmo de aprendizado, ou algoritmo de treinamento Hagan et al. (2014). O algoritmo do perceptron é do tipo aprendizado supervisionado. Isto significa que é fornecido um conjunto de exemplos (dados de treinamento) do comportamento apropriado da rede:
Onde é o saída desejada correspondente à entrada . Então a regra de aprendizado é usada para ajustar os pesos e o viés do neurônio de modo a mover as saídas do mesmo para mais próximo às saídas desejadas. Um conceito importante é a fronteira de decisão. Esta é definida para quando a função de ativação é igual a zero, isto é:
A fronteira de decisão é um hiperplano (um sub-espaço de dimensão em um espaço de dimensão ) no espaço de entrada. Para ficar mais concreto, como exemplo pode-se restringir a análise à duas entradas, então se o espaço de entrada tem 2 dimensões , logo o hiperplano é uma reta (1 dimensão) em que a saída é 0 de um lado e 1 do outro. Especificamente:
Isto é uma equação da reta do tipo onde e . Sendo a inclinação da reta, um vetor perpendicular a fronteira de decisão deve ter a inclinação . Portanto o vetor peso é perpendicular a reta formada pela fronteira de decisão. Desta maneira, este perceptron é capaz de classificar corretamente um conjunto de dados de duas dimensões no qual as duas classes podem ser separadas por uma reta. O algoritmo de aprendizado é responsável por ajustar a inclinação (através dos pesos) e a distância da origem (pelo viés) desta reta.
Desta maneira, é possível compreender as regras de aprendizado do perceptron para atualização dos pesos em 3 regras:
Se foi classificado corretamente, não realizamos nenhuma alteração;
Se era para ser classificado como , e foi classificado errado , soma-se o vetor de entrada: ;
Se era para ser classificado como , e foi classificado errado , subtrai o vetor de entrada: .
Dessa maneira, aproxima-se o vetor peso do vetor de entrada quando a classificação deveria ser e o foi classificado errado, e afasta-se quando a classificação correta é mas foi classificado incorretamente. Essas três regras ainda podem ser unificadas ao se notar que o sinal da operação com o vetor pode ser descrito pela diferença , que nada mais é do que uma medida simples do erro. Dessa maneira, de forma unificada pode-se escrever:
E lembrando que o viés pode ser descrito como um peso para uma entrada em que a entrada é , de maneira análoga:
A fim de aumentar o controle sobre a aprendizagem, pode-se considerar ainda uma taxa de aprendizado :
Perceptrons ainda são naturalmente limitados, essas limitações foram demonstradas em um livro chamado Perceptrons por Marvin Minsky e Seymour Papert. A fronteira de decisão do perceptron é linear, logo um perceptron pode ser usado para classificar problemas que podem ser descritos de maneira linearmente separável, porém infelizmente muitos problemas não são linearmente separáveis, como a porta lógica XOR Hagan et al. (2014).
Modelo Sigmoide
Outra limitação mais evidente do modelo do perceptron se encontra nos valores de saída que são binários. Além disso a regra de aprendizado foi desenhada para atualizar os valores de cada perceptron individualmente, então para a construção de uma rede neural em que se utiliza a saída de um perceptron () como entrada de outro perceptron (), seria necessário saber qual é o valor intermediário esperado (a saída de , que serve de entrada para ). Deste modo, para a construção de uma rede neural mais complexa, é necessário também um modelo genérico mais complexo.
Sigmoide é um tipo de neurônio artificial similar aos perceptrons, porém modificado para que pequenas variações nos pesos e viés causem apenas uma pequena variação na saída, uma vez que agora a saída é um valor contínuo. É por isso que sigmoides são os principais modelos de neurônios e junto com o algoritmo de aprendizado do gradiente descendente permitem a construção de redes mais complexas.
Para atingir esse objetivo, o neurônio sigmoide aceita entradas e saída entre 0 e 1, ou seja, não trabalha mais apenas com valores binários na saída. A função ativação clássica de um sigmoide é:
Pode-se conferir que para casos extremos em que e a função vale respectivamente:
Desta maneira, a função sigmoide mantém a saída entre os valores 0 e 1, porém não mais de forma binária, mas de maneira suave.
Gradiente descendente
A mudança na função de ativação do neurônio sigmoide permite que seja utilizado um novo algoritmo de aprendizado, mais complexo, mas que também permite a construção de redes mais complexas. Como a regra de aprendizado visa aproximar os pesos e viés de maneira que o resultado da rede se aproxime do resultado esperado, é interessante que seja possível quantificar o erro da rede ao classificar um conjunto de dados de treinamento. Assim, pode-se concentrar em minimizar esse valor.
Com esta finalidade define-se uma função custo, isto é, uma função que serve exatamente para quantificar o erro. Considerando que a rede pode apresentar mais de uma saída, pode-se escrever o vetor de saídas desejadas para um determinado vetor de entrada como . De forma mais explícita, para saídas possíveis temos . Então o elemento corresponde à saída desejada pelo neurônio para o vetor de entrada . De forma análoga, pode-se escrever o vetor dos resultados obtidos pela rede como . A partir desta notação, uma típica função custo pode ser escrita, para pesos e entradas, como Nielsen (2015):
Onde a norma de um vetor é definida como . Quando os pesos são atualizados, a expectativa é de que ocorra uma diminuição do valor da função custo, isto é, uma variação negativa. Para tornar os cálculos mais compactos, uma alternativa é absorver o viés no vetor dos pesos como um peso .
A diferencial total da função custo é dada por:
Pela definição do gradiente para dimensões do espaço de pesos temos , e definindo um vetor de variações dos pesos como , é possível então reescrever a variação da função custo como:
Supondo uma variação no vetor peso da seguinte forma: , espera-se que a função custo seja minimizada. Pois a diferencial da função custo torna-se, desde que a variação proposta seja pequena o suficiente:
Onde é chamada de taxa de aprendizado, análogo ao caso do perceptron. Portanto o algoritmo do gradiente descendente consiste em atualizar os pesos da seguinte forma:
E o gradiente da função custo, de forma mais específica:
Isto decorre da regra da cadeia. Vale destacar que enquanto é um vetor de constantes, o vetor é formado por elementos que são obtidos através da função de ativação. O primeiro termo entre parênteses no gradiente da função custo é simplesmente a diferença entre os resultados desejados e o obtido pela rede. Como a regra de aprendizado é aplicada depois da rede classificar os dados de treinamento, isto pode ser obtido diretamente a partir dos valores resultantes, sendo assim, resta unicamente a tarefa de calcular o segundo termo, que vai depender de detalhes específicos da rede.
Apesar de envolver um cálculo mais complicado que para o caso do perceptron, este algoritmo de aprendizado possui a vantagem de que só é necessário saber as saídas desejadas de toda a rede para aplicar a regra de aprendizado em cada um dos neurônios que compõem esta mesma rede.
Método Kernel
Perceptrons e sigmoides são modelos que são relativamente fáceis de implementar e otimizar, mas são classificadores lineares, isto é, são limitados a fronteiras de decisões lineares, é para lidar com essa questão que surge o método kernel. Este método tem como principal objetivo capturar padrões não-lineares nos dados mapeando-os em dimensões mais elevadas no qual exibem um padrão linear Carpuat (2017). Isto é feito à custas de um aumento no custo computacional necessário para realizar o treinamento. Porém, uma das vantagens que a computação quântica nos oferece em comparação à computação clássica é o aumento no poder computacional, uma vez que a quantidade de coeficientes aumenta exponencialmente com a quantidade de qubits e a natureza da mecânica quântica nos permite utilizar recursos de paralelismo. O problema que o método kernel se propõe a solucionar pode ser enunciado da seguinte forma: tendo duas classes de objetos, para um novo novo objeto é necessário classificá-lo em uma das classes Schölkopf et al. (2002).
Considerando então os seguintes dados empíricos:
Onde:
: conjunto de onde os padrões são retirados, chamado também de domínio;
entradas, casos, instâncias, observações;
: conjunto onde retira-se as saídas :
rótulos, alvos, saídas, observações.
Pode-se notar que há somente duas classes, ou seja, um padrão de reconhecimento ou classificação binária. É necessário um tipo adicional de estrutura, para generalizar os dados que não estamos vendo. Isto é, de maneira esquematizada:
Dado um novo padrão , queremos predizer o correspondente ;
Fazendo isso para cada nos leva a estimar uma função ;
Queremos escolher de forma que seja coerente aos exemplos de treinamento;
Precisamos então ter noções de similaridade em e .
A similaridade da saída é obtida de forma bastante direta, como há somente duas classes, os rótulos podem ser apenas idênticos entre si ou diferentes. Já a similaridade das entradas é mais complicado de se obter e constitui o núcleo do aprendizado de máquina. Consideramos uma medida de similaridade na forma:
Dados dois padrões e , a função retorna um número real, caracterizando sua similaridade. É assumido que é simétrico, isto é: para todo e então é denominado como kernel. Medidas gerais de similaridade são difíceis de serem estudadas. Um caso particular e simples de similaridade é o produto interno. Para dois vetores , lembrando que produto interno canônico é definido como , onde é o elemento de . A interpretação geométrica do produto interno canônico é que ele computa o ângulo entre os vetores e , desde que ambos sejam normalizados. Por fim, o produto interno também permite o cálculo da norma do vetor, conforme definido anteriormente .
Ainda é válido mencionar que se por um lado calcular produto interno significa ser capaz de lidar com todas construções geométricas, por outro lado o produto interno não é suficientemente geral para lidar com todos problemas Schölkopf et al. (2002). Mas restringindo o estudo aos problemas que pode-se utilizar o produto interno, é necessário ainda ser capaz de representar as entradas como vetores em algum espaço (que não precisa ser ). Para isso, usa-se o mapa:
Mesmo que os padrões originais existam em um espaço produto interno (um espaço em que há produto interno), pode ser desejável medidas de similaridade mais gerais obtidas com a aplicação de um mapa. Nesse caso normalmente será um mapa não linear. Então, chamando de espaço de características e sendo que denota a representação vetorial de em , a medida de similaridade do produto interno em é:
Desta forma então é possível lidar com padrões geométricos e estudar algoritmos de aprendizado usando álgebra linear e geometria analítica (e resolver problemas não-lineares). De forma resumida então:
Vamos ter um conjunto de entradas ;
Queremos classificar em ;
Em usamos um kernel pra medir as distâncias entre dois vetores : Um caso simples é o produto interno: .
Elementos são simétricos .
Algoritmo simples de reconhecimento de padrões
Nesta seção será abordado o algoritmo mais simples possível para reconhecimento de padrões. Assumindo que o dado está embutido em um espaço com produto interno , dessa maneira pode-se medir distâncias neste espaço. O objetivo do algoritmo é ser capaz de associar uma entrada não vista no treinamento à classe com a média mais próxima. Começando calculando a média das duas classes em :
Sendo que são o número de exemplos com rótulos . Então associa-se a entrada a classe com a média mais próxima, e isto por sua vez pode ser formulado como produto interno. O ponto médio entre e é:
Sendo que é o vetor apontando para o ponto . Define-se a classe de uma entrada e então verifica-se se o vetor diferença entre a entrada e o ponto médio entre os vetores de cada classe () tem um ângulo menor que com o vetor que indica a diferença entre as médias dos rótulos de saída , lembrando que é perpendicular a , ou seja, mais especificamente, se tem menos que com , então a entrada está mais próxima de do que de . Matematicamente temos que para um vetor de entrada qualquer vamos calcular:
Considerando que os elementos dos vetores são números reais escritos da seguinte forma: e . Então analisando apenas os primeiros componentes do produto interno (as outras são análogas):
Generalizando então para componentes:
Pelas definições de produto interno podemos reescrever:
E lembrando que , pode-se definir o deslocamento (offset) (uma medida da diferença de tamanho entre as médias) como:
Logo tem-se:
Esta equação induz um limite de decisão que tem a forma de um hiperplano. Reescrevendo esta expressão em termos dos componentes dos vetores de entrada , isto é, reescrevendo especificamente os vetores . Então expandindo a equação (33):
E o deslocamento assume, lembrando da equação 32:
Substituindo os produtos internos por uma função kernel genérica podemos reescrever então:
Exemplo
Sendo um espaço de 2 dimensões e limitando ao uso de10 pontos de exemplo no qual é conhecida a categoria ao qual pertencem (5 em cada). Então:
Classe 1:
Classe 2:
Computando então as médias:
Classe1:
Classe 2:
O ponto médio é:
E a distância entre as médias é então:
Então para exemplificar, classificando um novo ponto, , a distância com a média é:
O ângulo resultante é:
Ou ainda:
Então deve ser assimilado ao rótulo da primeira classe . Ainda é possível calcular o hiperplano, lembrando que e . Então igualando a expressão dentro da função sinal na expressão 33 e notando que:
Então o hiperplano é:
Logo o hiperplano é uma reta em . Isso significa que esse hiperplano (essa reta) separa as duas classes de pontos, isto é, todos os pontos de um lado desta reta (lado positivo no eixo ) serão classificados com em uma classe, e todos os pontos do outro lado (lado negativo em ), irão pertencer a outra classe.
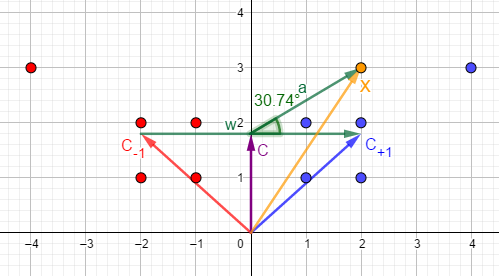
Figure 1:Ilustração referente ao exemplo do método kernel.
- Zuben , F. J. V., & Attux , R. R. F. (2007). Projeto de Redes Neurais Artificiais. DCA - FEEC Unicamp. ftp://ftp.dca.fee.unicamp.br/pub/docs/vonzuben/ia353_1s07/topico4_07.pdf
- Rodrigues, J. (2014). Modelo McCulloch e Pitts. CCA UFES. http://jeiks.net/wp-content/uploads/2014/08/RNA-Slides_04.pdf
- Nielsen, M. A. (2015). Neural Networks and Deep Learning. Determination Press. https://books.google.com.br/books?id=STDBswEACAAJ
- Rojas, R. (1996). Neural Networks - A Systematic Introduction (p. 502 p.). Springer-Verlag. http://page.mi.fu-berlin.de/rojas/neural/
- Hagan, M. T., Demut, H. B., Beale, M. H., & Jesús, O. D. (2014). Neural Network Design. http://hagan.okstate.edu/NNDesign.pdf
- Carpuat, M. (2017). Kernel Methods. http://www.cs.umd.edu/class/spring2017/cmsc422/slides0101/lecture18.pdf
- Schölkopf, B., Smola, B. S. A. J., Smola, A. J., Bach, F., Press, M., & Scholkopf, M. D. M. P. I. B. C. T. G. P. B. (2002). Learning with Kernels: Support Vector Machines, Regularization, Optimization, and Beyond. MIT Press. https://books.google.com.br/books?id=y8ORL3DWt4sC