Perceptron
A primeira adaptação surge nos componentes dos vetores de pesos e entradas. Além de seus elementos estarem restritos à valores binários , é necessário utilizar apenas vetores normalizados devido à condição de normalização imposta ao estado do sistema pela mecânica quântica. Desta forma, passando a denotar e os vetores normalizados correspondentes a e , respectivamente, e seus elementos valem , onde é a dimensão dos vetores.
Além disso, a função ativação também sofre uma adaptação. Passa-se a utilizar agora:
Desta forma temos como função de ativação uma função com a mesma estrutura da probabilidade de medirmos determinado estado em nosso sistema, dado pelo 3º postulado da mecânica quântica, adequando melhor então o modelo para ser implementado em um computador quântico, uma vez que a função de ativação é um valor mensurável através de um dispositivo quântico. Para facilitar esta implementação, outra mudança consiste no fato de que o limiar volta a aparecer explicitamente, desta forma restringimos a função ativação para ser apenas o quadrado do produto interno e comparamos o resultado com o limiar separadamente. O produto interno agora corresponde a:
E, por fim, a última adaptação necessária surge na regra de aprendizado. Baseado no mesmo conceito clássico de aproximar ou afastar o vetor peso do vetor entrada sob determinadas condições, para um modelo binário, foi proposto o seguinte esquema de aprendizado em caso de classificação incorreta Tacchino et al. (2019):
Se era pra ser classificado como e foi classificado como , para aproximar, então o sinal de uma fração aleatória dos elementos do vetor peso em que os sinais não coincidiam com o respectivo elemento do vetor de entrada são alterados de forma que passarão a coincidir;
Se era pra ser classificado como e foi classificado como , para afastar, então o sinal de uma fração aleatória dos elementos do vetor peso em que os sinais coincidiam com o respectivo elemento do vetor de entrada são alterados de forma que não coincidam mais.
Este conjunto de adaptações permite que a função de ativação seja calculada em um computador quântico, e com esse resultado podemos então rodar o algoritmo de aprendizado em um computador clássico, dessa forma temos um esquema de treinamento híbrido. Esta é uma forma com que podemos lidar com a não-linearidade, uma vez que a computação quântica herda da mecânica quântica uma natureza intrinsecamente linear.
Em princípio modelos que utilizem da computação quântica para o cálculo do produto interno apresentam uma vantagem exponencial em termos da capacidade de armazenamento de dados em comparação com modelos clássicos, porém é necessário uma discussão mais aprofundada sobre a real vantagem Tacchino et al. (2019).
Sigmoide
A principal adaptação proposta para o modelo sigmoide também está nos elementos dos vetores entradas e pesos, pois agora passa-se a utilizar números complexos, e considera-se que as variáveis são fases destes mesmos. A escolha de manipular somente a fase decorre que alterar o módulo dos coeficientes se torna mais trabalhoso uma vez que precisamos garantir ainda a condição de normalização do vetor de estado do sistema (e de cada qubit individual que compõem o sistema também). Tendo quaisquer vetores de entrada e pesos de tamanho , quando normalizados valem:
Dessa forma, o produto interno também passa a ser:
Onde . De maneira análoga ao caso binário, e pelos mesmos motivos, a função ativação é definida como o quadrado do módulo deste produto:
E sendo as funções seno e cosseno funções ímpares e pares, respectivamente, os termos simétricos também terão a seguinte propriedade:
Logo, pode-se escrever a função ativação de forma genérica:
Novamente, de maneira análoga ao caso binário, a saída da função ativação é obtida com o uso de um computador quântico e o treinamento é realizado em um computador clássico. Vale a pena aqui destacar que ambos os modelos realizam exatamente o mesmo cálculo no computador quântico: (). A diferença entre os modelos quanto a função ativação, está apenas nos valores dos elementos dos vetores entradas e pesos. Enquanto para o caso contínuo os elementos valem , sendo uma variável contínua, para o caso binário os dois valores são obtidos para os casos extremos de , isto é, temos +1 quando e -1 quando . Desta forma, é possível tratar o caso contínuo como o caso geral do binário.
Método kernel
Uma das principais limitações que surge quando busca-se implementar um modelo de inteligência artificial em um computador quântico, é que este último funciona baseado nos princípios da Mecânica Quântica. Então, devido à característica linear desta última, um computador quântico também opera de maneira linear. Porém muitos modelos de aprendizado de máquina não são lineares, afinal há diversos problemas de classificação que não podem ser resolvidos diretamente de maneira linear.
Para superar este problema quando foi abordado modelos de redes neurais, então foi proposto um esquema de treinamento e classificação híbrido, isto é, parte era executado em um computador quântico e parte em um computador clássico, de maneira que é possível utilizar o computador quântico mesmo que o modelo como um todo não seja linear. Já o método kernel, conforme foi discutido anteriormente, além de ser naturalmente um modelo que se utiliza de propriedades vetoriais assim como a Mecânica Quântica, o que já o torna um bom candidato de modelo de classificação binária a ser utilizado em computadores quânticos devido a natureza vetorial e matricial da Mecânica Quântica, também apresenta nativamente uma solução para lidar de maneira linear com problemas não lineares: levar os dados de entrada para um espaço de dimensão superior.
Pois ainda que no espaço original seja necessário um método de classificação não-linear, é possível que neste novo espaço de dimensão superior um modelo de classificação linear seja suficiente. É por este motivo que como foi mencionado anteriormente, mesmo que o espaço original seja dotado de produto interno, ainda pode nos ser interessante levar os dados para um espaço de dimensão superior.
O objetivo deste tópico é apresentar um exemplo capaz de ilustrar melhor este potencial. Porém diferente dos métodos anteriores que pudemos discutir de forma generalista sem propor nenhum problema a ser resolvido, no método kernel o mapa responsável por levar os dados de entrada para uma dimensão superior depende do problema que estamos tentando solucionar em particular. Então, vamos construir um modelo no qual o objetivo é classificar se novos pontos gerados aleatoriamente dentro de uma região quadrada, estão no interior ou exterior de um círculo contido e centralizado no interior deste quadrado. Se realizarmos uma distribuição aleatória de pontos e separarmos em duas classes os pontos no interior e no exterior no círculo, esperamos que o ponto médio de ambas distribuições seja no centro do mesmo, de forma que não seria possível separar as classes corretamente em duas dimensões.
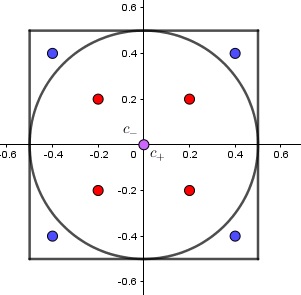
Círculo circunscrito no quadrado em 2 dimensões.
Dessa maneira, uma alternativa é levar as entradas para três dimensões. Isto será feito projetando o plano 2D sob uma superfície em 3D, especificamente um cone. A equação geral de um cone é dada por:
Neste ponto é necessário prestar atenção em algumas condições que a Mecânica Quântica impõe. Trabalhando com um sistema de 2 qubits, então um estado qualquer do sistema é dado por:
Pela condição de normalização, tem-se que , o que implica obviamente em que . A princípio, a amplitude será ignorada para que seja possível focar nas outras e em um espaço de 3 dimensões. Escrevendo um conjunto de vetores ortogonais no espaço 3D e utilizando as outras três amplitudes:
Mas, lembrando que, pela condição de normalização, para qualquer vetor escrito como uma combinação linear destes, isto é , não é possível ter módulo maior que 1, ou seja . Isso implica no fato de que algumas configurações não são permitidas, por isso é necessário reduzir o tamanho do quadrado inicial, pois neste modelo, seria impossível gerar pontos que correspondessem à algumas coordenadas como por exemplo . Pode-se notar também que o valor máximo simultâneo de três coeficientes é . Logo, de modo análogo ao que foi feito em duas dimensões, isto é, um quadrado centrado na origem, agora há um cubo de 3 dimensões também centrado na origem, e este cubo está inteiramente contido em uma esfera de raio 1 o que respeita a condição de normalização, pois é possível apontar para qualquer ponto no interior deste quadrado com um vetor de módulo menor que 1. Lembrando que até o momento toda discussão centrou-se em 3 dos coeficientes. Logo, o último coeficiente é responsável por garantir a normalização do vetor de estado do sistema, isto é .
Até aqui, foi garantido que as coordenadas assumam valores aceitáveis. Porém, também é necessário garantir que o mesmo também aconteça na coordenada , isto é, é necessário escolher as contantes na equação do cone de modo que dado um ponto qualquer, também esteja contido na caixa, isto é Chamando de a função responsável por projetar o plano 2D nesta superfície, então:
Dito isso, os valores escolhidos foram , pois assim é garantido que os pontos mais “altos” da superfície ainda estão contidos no cubo, isto é . Logo:
Agora é possível projetar os pontos inicialmente em 2 dimensões em um espaço de 3 dimensões utilizando a função (12), e, apesar dos pontos médios estarem aproximadamente nas mesmas coordenadas em e , deverão apresentar uma distância considerável em , tornando possível a classificação correta de novos pontos.
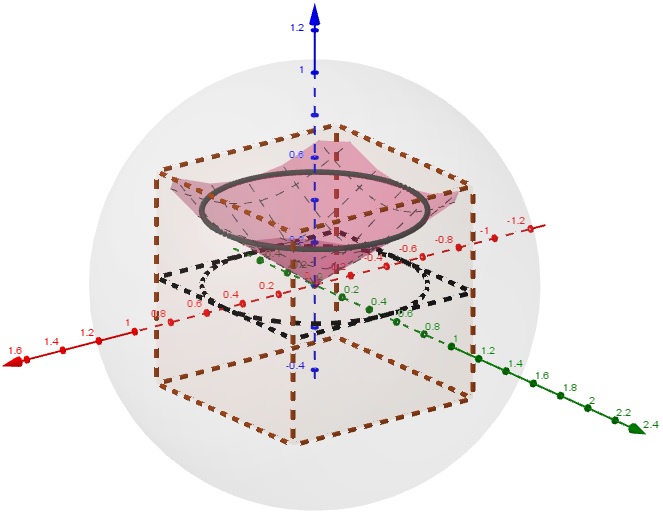
Esfera de raio 1 com o quadrado de lado 1 em seu interior e a projeção da circunferência no cone.
Porém, até agora foi negligenciado. Mas o produto interno será calculado em um espaço de 4 dimensões. Pode-se dizer que a última componente da quarta dimensão é inversamente proporcional ao módulo do vetor formado pelas outras 3 componentes. Ainda que não haja recurso visual para visualizar 4 dimensões, o produto interno segue apresentando as propriedades desejas. Por exemplo, dado um vetor qualquer, o produto interno dele com ele mesmo apresenta o máximo de semelhança:
Vale destacar duas coisas: apenas a folha de cima do cone é utilizada, e os termos e aparecem sempre ao quarado na função (12), ou seja . Então, um vetor em sentido contrário no plano é , e o produto interno então é:
Os pontos menos semelhantes são pontos nos extremos em que , então:
Resumindo, nosso método consiste em:
Definimos um quadrado de lado máximo e centrado na origem;
No interior do quadrado definimos um círculo também centrado na origem;
Geramos pontos aleatórios em 2 dimensões no interior deste quadrado;
Levamos estes pontos para o espaço de Hilbert de 4 dimensões, onde cada ponto se torna um vetor do tipo:
Sendo os coeficientes dados por:
Aplicamos então o método kernel no espaço de 4 dimensões e associamos novos pontos à uma das classes binárias (dentro ou fora).
- Tacchino, F., Macchiavello, C., Gerace, D., & Bajoni, D. (2019). An artificial neuron implemented on an actual quantum processor. Npj Quantum Information, 5(1). 10.1038/s41534-019-0140-4